Ein Anwalt haftet für das, was er schreibt. Er haftet auch für das, was er übersieht.
Seit zwei Jahren beobachte ich in den Sozietäten dieselbe Bewegung. Partner sprechen über künstliche Intelligenz. Sie testen Sprachmodelle. Sobald ein Anbieter ein neues System veröffentlicht, wird die Lizenz gewechselt. Man glaubt, ein besseres Modell führe zu besseren Schriftsätzen. Das ist ein Irrtum.
Kirkland & Ellis hat 500 Millionen Dollar in eine eigene Technologieplattform investiert. Nicht, um eigene Grundlagenmodelle zu trainieren. Sondern um die eigene Dateninfrastruktur zu beherrschen.
Die Schwachstelle liegt nicht in der Leistung der Sprachmodelle. Sie liegt in den Archiven der Kanzleien. Kanzleien besitzen Millionen von Dokumenten: Verträge, Gutachten, Schriftsätze, Memos. Doch dieses Wissen liegt in Silos – in iManage, in SharePoint, auf Netzlaufwerken. Die Dokumente sind stumm. Ein Sprachmodell, das isoliert darauf zugreift, rät. Es berechnet Wahrscheinlichkeiten von Wortfolgen. Vor Gericht reicht Wahrscheinlichkeit nicht aus. Dort gilt der Beweis.
Ein Sprachmodell benötigt Führung. In der Technik nennt man das einen Harness – ein Geschirr. Es zwingt das Modell in die Faktenbasis der Kanzlei.
I. Das Missverständnis: Modellwettlauf gegen Datenarchitektur
Die Diskussion in den Kanzleien leidet an einer Verwechslung. Man hält allzu oft ein Digitalisierungsproblem für ein Problem der künstlichen Intelligenz.
Genau diesen Befund formulieren Tobias Voßberg und Benedikt Raquet in ihrem Podcast Bis Keiner Mehr Denkt. Ihre Diagnose ist schlicht und zutreffend: Kanzleien haben kein KI-Problem, sie haben ein Digitalisierungsproblem. Wer sich mit Legal Tech befasst, sollte diese Reihe hören. Die beiden Praktiker beschreiben den Istzustand ohne Illusionen.
Ein Sprachmodell ist probabilistisch. Es weiß nichts über Wahrheit oder Falschheit. Es generiert den statistisch plausibelsten nächsten Textbaustein. Wenn die Kanzlei diesem Modell eine Frage vorlegt, ohne die relevanten Tatsachen deterministisch bereitzustellen, halluziniert das System. Für den Laien klingt die Antwort überzeugend. Für das Gericht ist sie unbrauchbar.
| Dimension | Der Modellwettlauf (Status quo) | Die Datenarchitektur (Harness) |
|---|---|---|
| Strategischer Ansatz | Reaktiv. Man jagt Benchmarks hinterher. | Proaktiv. Man baut einen Wissensgraphen auf. |
| Wissenskapital | Abhängigkeit von US-Konzernen. | Unabhängiges, kanzleieigenes Eigentum. |
| Ergebnisqualität | Probabilistisch. Es besteht Halluzinationsgefahr. | Belegt. Jede Aussage ist durch Akten gedeckt und wird dagegen geprüft. |
| Integration | Redundante Suche über Silos hinweg. | Einheitlicher Daten-Layer ohne Kopien (No-ETL). |
| Haftung | Hohes Risiko. Keine lückenlose Belegkette. | Beweiswert durch revisionssicheres Audit-Ledger. |
Der eigentliche Schutz vor der Entwertung anwaltlicher Arbeit – der sogenannte Burggraben (Data Moat) – entsteht nicht durch die Wahl zwischen Anthropic, Google oder OpenAI. Er entsteht durch die Strukturierung der kanzleieigenen Daten.
II. Die Fünf-Schichten-Architektur
Ein System für Juristen muss modular sein. Modelle altern rasch; die Architektur muss bestehen bleiben. Vor allem muss sie das Berufsgeheimnis wahren. § 203 StGB verlangt keine Absichtserklärungen, sondern technische Garantien.
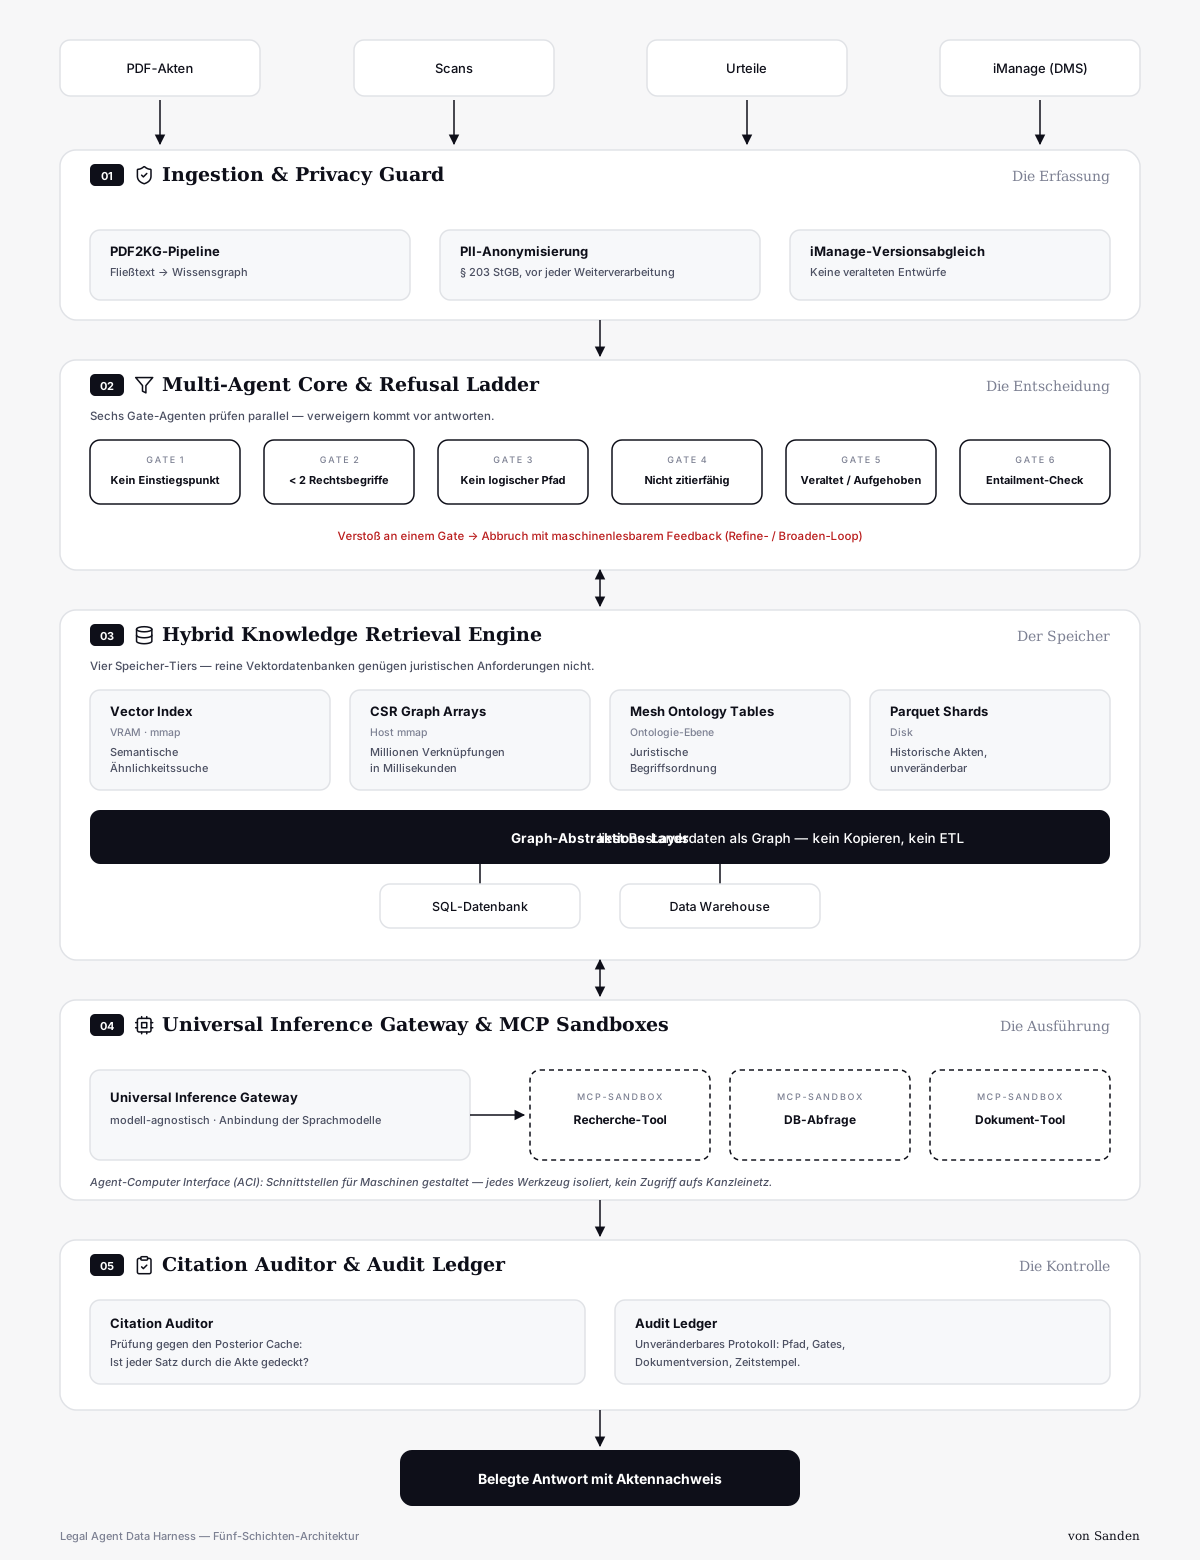
Layer 1: Ingestion & Privacy Guard
Die Erfassung. Unstrukturierte Bestandsdaten – PDF-Akten, Scans, Urteile – durchlaufen eine sogenannte PDF2KG-Pipeline. Sie überführt Fließtext in Wissensgraphen. Hier greift der Schutz des § 203 StGB. Personenbezogene Daten (PII) und Mandantengeheimnisse werden vor jeder Weiterverarbeitung automatisiert pseudonymisiert; der Zugriff bleibt über Ethical Walls und Berechtigungen strikt auf den jeweiligen Mandatskontext beschränkt. Zugleich gleicht das System die Dokumentenstände mit iManage ab. Ein Entwurf aus dem Jahr 2021 darf einen aktuellen Schriftsatz nicht kontaminieren.
Layer 2: Multi-Agent Core & Refusal Ladder
Die Entscheidung. Hier arbeiten spezialisierte Software-Agenten. Ihre erste Aufgabe ist nicht das Antworten, sondern das Verweigern. Sie prüfen die Eingabe parallel über eine sechsgliedrige Prüfkette. Entspricht eine Anfrage nicht den Standards, bricht das System ab.
Layer 3: Hybrid Knowledge Retrieval Engine
Der Speicher. Reine Vektordatenbanken genügen juristischen Anforderungen nicht. Dieser Layer trennt die Datenhaltung in vier technische Schichten:
- Vector Index: Liegt im VRAM und schnellen Speicher (
mmap). Er dient der semantischen Ähnlichkeitssuche. - CSR Graph Arrays: Liegen im Arbeitsspeicher des Hosts (
Host mmap). Compressed Sparse Row (CSR) ermöglicht es, Millionen logischer Verknüpfungen in Millisekunden zu durchlaufen. - Mesh Ontology Tables (ein Arbeitsbegriff dieser Architektur): Bilden die juristische Begriffsordnung ab.
- Parquet Shards: Liegen auf Festplatten. Sie speichern historische Aktenbestände unveränderbar und speichereffizient.
Als Abstraktion dient PuppyGraph. Es liegt direkt über Postgres oder Snowflake. Es kopiert keine Daten. Es führt keinen fehleranfälligen ETL-Prozess aus. Die Daten bleiben an ihrem Ort; PuppyGraph liest sie als Graph. Das No-ETL-Prinzip gilt für die strukturierten Bestandssysteme – unstrukturierte Dokumente durchlaufen weiterhin die PDF2KG-Pipeline aus Layer 1.
Layer 4: Universal Inference Gateway & MCP Sandboxes
Die Ausführung. Werkzeuge und Datenbankabfragen werden über das Model Context Protocol (MCP) angebunden. Entscheidend ist das Agent-Computer Interface (ACI): Die Schnittstellen werden nicht für menschliche Nutzer gestaltet, sondern für Maschinen. Jedes Werkzeug läuft isoliert in einer Sandbox. Ein Agent kann Daten abfragen; er kann das Kanzleinetzwerk nicht beschädigen.
Layer 5: Citation Auditor & Audit Ledger
Die Kontrolle. Jede Behauptung des Modells wird gegen den Posterior Cache geprüft – einen Zwischenspeicher, der pro Dokument festhält, welche Aussagen mit welcher Belegstärke gedeckt sind (ebenfalls ein Arbeitsbegriff dieser Architektur). Das System verifiziert so, ob der erzeugte Satz tatsächlich durch die herangezogene Akte gedeckt ist. Das Audit Ledger protokolliert den gesamten Ablauf unveränderbar. Es ist das Gutachten über das Gutachten.
III. Die 6-stufige Refusal Ladder: Die Pflicht zu schweigen
Ein Jurist, der den Sachverhalt nicht kennt, darf keinen Rat erteilen. Er muss schweigen. Ein Sprachmodell neigt dazu, Gefälligkeitsantworten zu erfinden.
Der Data Harness setzt eine sechsgliedrige Abweisungsleiter ein. Sechs Gate-Agenten prüfen die Anfrage nicht nacheinander, sondern zeitgleich.
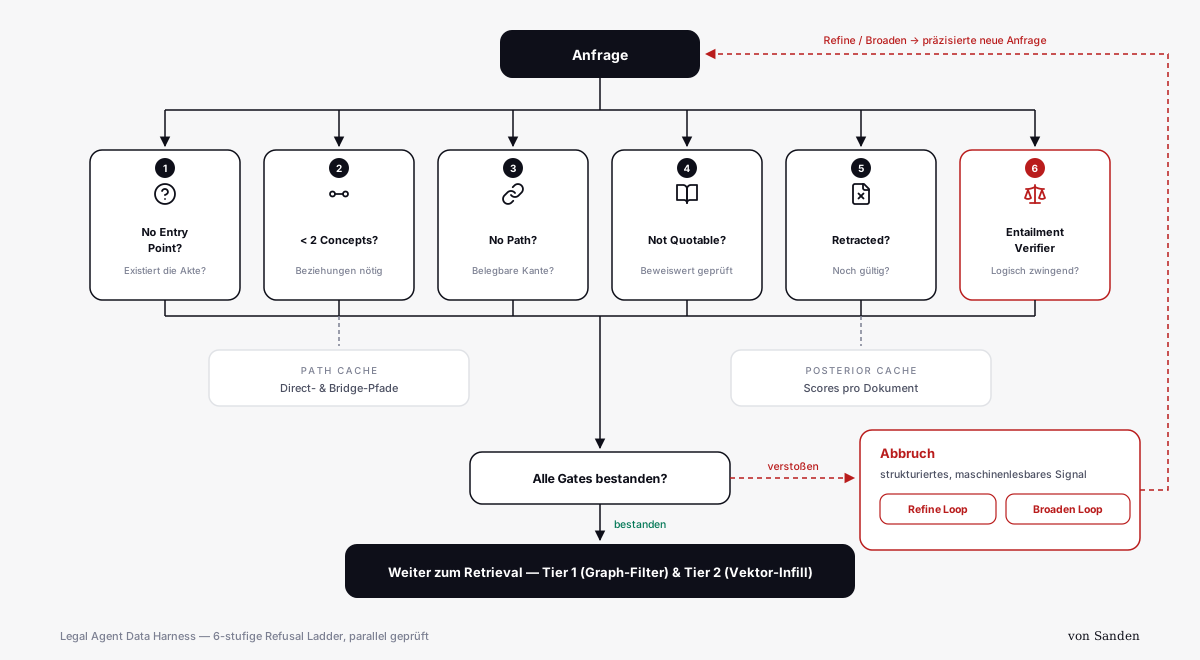
- No Entry Point? Gibt es zu den genannten Mandanten oder Sachverhalten überhaupt Knoten im Kanzleigraphen? Wenn die Akte nicht existiert, endet die Bearbeitung.
- < 2 Concepts? Recht entsteht aus Beziehungen. Ein einzelner Begriff – etwa „Frist“ – genügt nicht. Es müssen mindestens zwei verknüpfbare Rechtsinstitute vorliegen, etwa „Frist“ und „Versäumnis“.
- No Path? Liegt eine belegbare Verbindung zwischen den Entitäten vor? Behauptet der Nutzer einen Zusammenhang zwischen zwei Verträgen, den die Aktenlage nicht stützt, bricht der Agent ab.
- Not Quotable? Handelt es sich um eine tragfähige Quelle? Ein unfertiger interner Entwurf darf nicht wie ein rechtskräftiges Urteil behandelt werden.
- Retracted? Ist die Rechtsnorm geändert worden? Wurde die Entscheidung des Oberlandesgerichts durch den Bundesgerichtshof aufgehoben? Dies ist die klassische Haftungsfalle.
- Entailment Verifier: Folgt das Ergebnis zwingend aus den Prämissen? Erlaubt der Tatbestand die rechtliche Würdigung logisch?
Schlägt ein Gate an, bricht das System ab. Es gibt kein vages Ergebnis aus. Es erzeugt stattdessen ein strukturiertes, maschinenlesbares Signal. Dieses Signal erlaubt es dem System, die Suchanfrage selbstständig zu verfeinern (Refine Loop) oder den Suchraum methodisch zu erweitern (Broaden Loop).
IV. Das zweistufige Retrieval: Struktur vor Erzählung
Standard-RAG (Retrieval-Augmented Generation) scheitert an komplexen Akten. Vektoren vergleichen Wortähnlichkeiten. Sie übersehen logische Brüche. Je größer der Kontext wird, desto unpräziser wird das Modell (Context Rot).
Die Lösung ist eine strikte Trennung von Struktur und Erzählung.
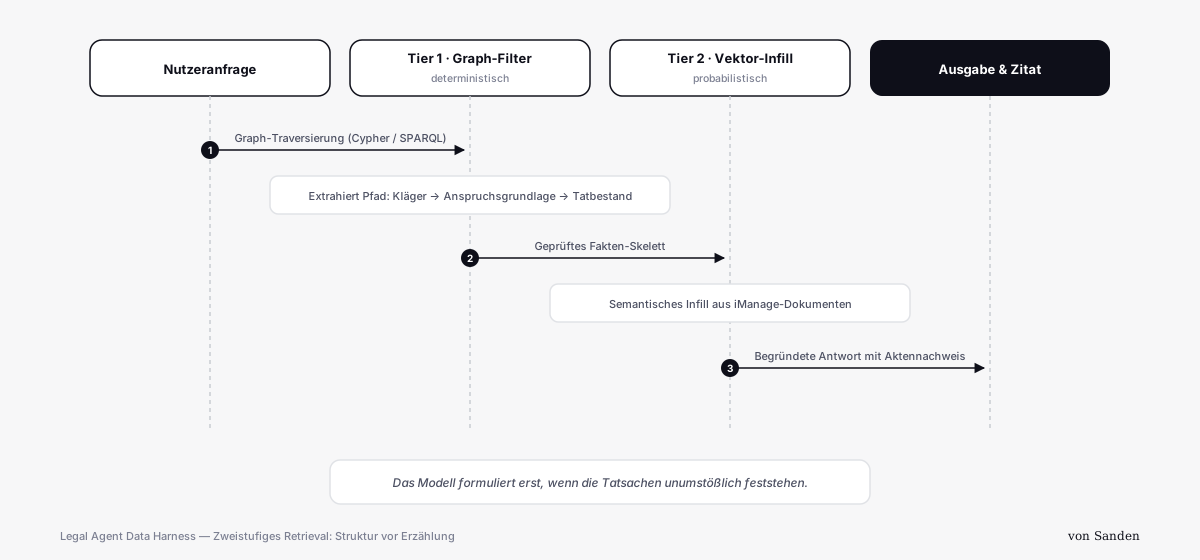
- Tier 1: Graph-Filter (Deterministisch). Das System sucht zunächst keine Texte. Es sucht Relationen: Gläubiger $\rightarrow$ Vertrag $\rightarrow$ Verzug $\rightarrow$ Schaden. Dies geschieht über Graph-Abfragesprachen (Cypher oder SPARQL). Es gibt keinen Raum für Interpretationen. Entweder der Pfad existiert in den Daten oder er existiert nicht.
- Tier 2: Vektor-Infill (Probabilistisch). Erst wenn das strukturelle Skelett steht, wird Text hinzugefügt. Nun füllt der Vektorspeicher die Details auf: Formulierungen aus Zeugenaussagen, Begründungssätze aus Schriftsätzen, der genaue Wortlaut einer Klausel.
Das Modell formuliert erst, wenn die Tatsachen unumstößlich feststehen.
V. Duale Wissensrepräsentation: Die zwei Welten einer Kanzlei
Eine Kanzlei operiert in zwei verschiedenen Sphären. Eine tragfähige Datenarchitektur muss diese beiden Sphären methodisch trennen.
| Kriterium | Normative Logik (Welt des Rechts) | Operative Daten (Welt der Kanzlei) |
|---|---|---|
| Technologie | RDF / OWL | Neo4j LPG (Labeled Property Graph) |
| Gegenstand | Gesetze, Richtlinien, Standards (ELI, ECLI, SKOS). | Mandate, Fristen, Aktenzeichen, Zeugen, Verträge. |
| Funktionsweise | Logische Ableitungen über deterministische Reasoner. | Schnelle Pfadsuche mit Kanten-Metadaten. |
| Verankerung | Universelle juristische Ontologien (Mesh Ontology). | Kanzlei-Silos (iManage, SharePoint, Datev). |
Die normative Welt gehorcht formalen Gesetzen. Wenn ein Gesetz Tatbestandsmerkmale definiert, gilt die Prädikatenlogik. Hierfür ist das Resource Description Framework (RDF) und die Web Ontology Language (OWL) geschaffen.
Die operative Kanzleiwelt ist dynamisch. Mandanten rufen an, Fristen laufen ab, Entwürfe ändern sich stündlich. Dies erfordert Labeled Property Graphs (LPG).
PuppyGraph verbindet diese beiden Repräsentationen. Es bildet eine logische Schicht über den vorhandenen Datenbanken. Es zwingt Kanzleien nicht dazu, ihre sensiblen Datenbestände in ein neues Einzelsystem zu migrieren. Es liest Daten da, wo sie liegen – in Snowflake, in Postgres – und macht sie als zusammenhängenden Graphen abfragbar.
VI. Praxis-Integration: Die Kanzlei-Infrastruktur
Ein System, das nicht in den Arbeitsalltag passt, wird nicht genutzt. Der Harness setzt an der bestehenden IT an:
- Microsoft Universe: Große Kanzleien nutzen Microsoft 365. Der Harness bindet Microsoft Syntex (heute SharePoint Premium) ein, um Dokumente automatisch mit Metadaten zu versehen. Power Automate dient als Nervensystem: Veröffentlicht ein Gericht eine neue Entscheidung, schlägt der Concept Linker an und prüft sofort, welche laufenden Verfahren der Kanzlei betroffen sind.
- iManage-Synchronisation: Die Arbeit eines Anwalts vollzieht sich in Versionen. Der Harness synchronisiert sich direkt mit dem Versionsverlauf von iManage. Er stellt technisch sicher, dass kein Modell auf Grundlage einer verworfenen Fassung argumentiert.
VII. Revisionssicherheit und das Urteil
In der juristischen Arbeit gibt es keine Entschuldigung für Unwissenheit. Wenn ein Associate einen Fehler macht, haftet die Kanzlei – je nach Rechtsform der Partner persönlich. Wenn eine Maschine einen Fehler macht, gilt nichts anderes.
Layer 5 – das Audit Ledger – entzieht der künstlichen Intelligenz den Charakter der Unberechenbarkeit.
Jeder Schritt wird festgehalten. Das System speichert nicht bloß die abgegebene Auskunft. Es speichert den Pfad im Graphen. Es dokumentiert, welche Gate-Agenten zugestimmt haben. Es verzeichnet das genaue Dokument, die exakte Versionsnummer in iManage und den Zeitstempel der Ingestion.
Sollte ein Mandant oder eine Versicherung Jahre später fragen, auf welcher Grundlage eine Auskunft erteilt wurde, muss die Kanzlei nicht mutmaßen. Das Ledger liefert das Protokoll.
Drei Schritte zur Umsetzung
Kanzleien müssen nicht auf neue Sprachmodelle warten. Sie müssen ihre Hausaufgaben machen.
- Ontology Mapping: Definition der semantischen Struktur. Was ist ein Mandat, was eine Partei, was eine Frist?
- Connector Setup: Anbindung der vorhandenen Datenbanken an PuppyGraph – ohne Datenmigration, ohne ETL.
- Agent Deployment: Inbetriebnahme der Refusal Ladder und Einbindung in das gewohnte Frontend der Anwälte.
Am Ende geht es nicht um Technik. Es geht um Sorgfalt. Ein gutes Sprachmodell ist austauschbar. Eine unanfechtbare Datenarchitektur bleibt.